Oyuncu Beyin Serisi : Oyuncu Beynimiz ile Oyuncu Yapay Zeka ile kapışıyor, tahminleri alalım!
İnsanlığın her daim kendisini daha değerli ve merkezde görmesi çok popülerdi. Yaşadığımız dünyayı bile diğer geegenlerin onun etrafında döndüğünü düşündüğümüz dünya merkezli evreni görebildiğimiz ve ispatlayabildiğimiz halde 1500lü yıllarda Kopernic’in önderliğinde kabul görmeye başlamış. Yapay Zekanın da biz insan zekasını geçebileceğine dair de çok eskiden beri bir ön yargı mevcut insanın hem daha güçlü hem de daha zeki olduğuna dair. Bunu da Amerika’da sanayii devrimi sırasında bir hikayeyle anlatırlar.
870’lerde ABD’de demiryolu tünelleri açan, siyahi,çok uzun boylu ve güçlü bir işçiydi John Henry. İşi “steel-driving” denen bir kalemi çekiçle kayaya çakarak dinamit konacak delikleri açmak. Bir gün şirket, işçilerin yerine geçmesi için buharla çalışan bir delme makinesi getirdi. Yani karşısındaki aslında tam bir robot olmasa da bir makineydi.
John Henry bu duruma çok kızdı ve makinenin işçilerden daha güçlü ve hızlı olamayacağını kanıtlamak için yarışmaya girdi. Elinde iki çekiçle dağı delmeye başladı ve o günkü makineyi geçerek kazandı. Ama yarış bitince kısa bir süre sonra yorgunluktan yere yığılıp öldü. Anlatımlara göre kalbi dayanamadı ve çekici hâlâ elinde vefat etti.
Hikâyenin acı bir ironisi var. John Henry kazandı ama bu zafer hayatına mal oldu, makineler de sonunda yine işçilerin yerini aldı. Bu yüzden hem işçi onurunun ve insan iradesinin, hem de otomasyon karşısındaki trajik direnişin sembolü bu hikaye olmuştur.
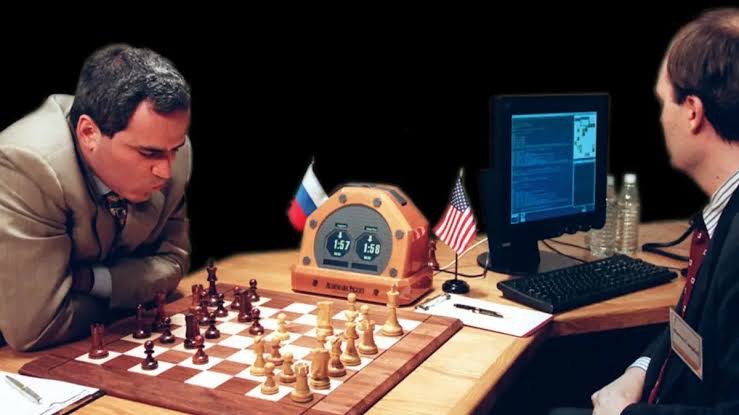
1997 yılında ben de 15-16 yaşlarında teknolojiye meraklı bir gençken soğuk savaş döneminin de verdiği bir üstün ve sürprizlerle dolu Rus toplumundan çıkan bir satranç ustası, Amerikalı IBM firmasının yıllardır tüm satranç hamlelerini öğreterek geliştirdiği ve adına da “Deep Blue-Derin Mavi” dedikleri bilgisayar ile maça çıkıyordu. Rus ve Amerikan vurgusunu neden yaptığımı maçın yapıldığı masadaki Rus ve Amerikan bayraklarından da daha iyi anlayabiliriz. Aslında aralarında bu ilk maç değildi ve geçtiğimiz yıllarda yapılan maçta Kasparov oyun kaybetse de maçları 4-2 ve 3-1 gibi skorlarla kazanmıştı. Ama bu maçta son oyunda Kasparov’un bilgisayara insan eliyle müdahale edildiğini belirterek Deep Blue öndeyken maçı bıraktı. Masadan sinirle kalkarak söylemelerini izlediğim televizyonda halen aklımdaydı, acaba yapay bir zeka bizden daha iyi oyun oynayabilecek mi? Basit bir şekilde insanların hamlelerini mi kopyalıyor yoksa bizim düşünemediğimiz stratejiler kurabilecek mi?
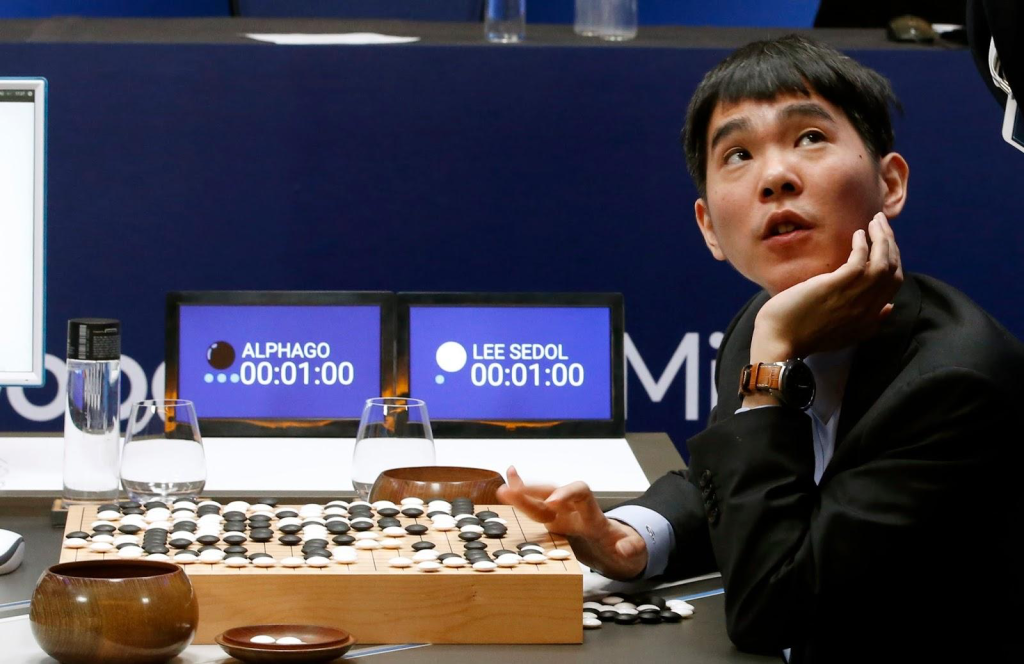
2010’lu yıllarda da yine haberlere bu sefer daha karmaşık ve milyar olasılığı ile oynanan bir oyun olan GO oyunu için bir seri maç düzenlendi. Bu oyunun kasparovu denilebilecek çoklu sayıda dünya şampiyonluğu bulunan Koreli Lee Sedol ile AlphaGo isimli bir yapay zeka ile bir seri maç yaptı ve ilk maçlarda Sedol kazanırken AlphaGo’nun 2016’daki bir maçta yaptığı 37. hamle, insan uzmanların alışılmış stratejilerinin dışına çıkarak oyun dünyasında büyük yankı uyandırdı. Uzmanların oyunun başında çok ta akıllı gibi gözükmeyen bir adımı normal oyunlarda 10.000de 1 olabilen bir adım olarak görmüştü, rakibi Sedol da o dönemki hamle düşünmesi süresi 1 dakikanın altındayken o hamle sonrası 15 dakika gibi süre düşündü ve sonrasında 211.hamlede oyun 4.saatine girerken Sedol de yenilmişti. Sedol oynadıkları bu 2.maç için “ilk maçta olumlu anlamda şaşırmıştım, bu maçtan sonra söyleyecek söz bulamıyorum kesinlikle hiçbir rakibime benzemiyor ve çok yaratıcı oynadı.” demişti.
Yapay zekânın oyunlarla ilişkisini dört aşamada inceleyebiliriz:
- 1. Kural tabanlı dönem: Bilgisayar, önceden tanımlanan kurallara göre hamle yapar.
- 2. Arama ve hesaplama dönemi: Bilgisayar, olası hamleleri değerlendirerek en iyi seçeneği bulmaya çalışır. Satranç için geliştirilen Deep Blue bunun önemli örneklerindendir.
- 3. Makine öğrenmesi dönemi: Sistem, verilerden ve deneyimlerden öğrenerek performansını geliştirir ve en iyi olasılığı seçer.
- 4. Kendi kendine öğrenme dönemi: AlphaZero gibi sistemler, kendi oyunlarını oynayarak yeni stratejiler keşfedebilir rakibe göre oyunda kararları değiştirebilir.
AlphaGO geliştiren ekip aslında oyunu hep geçmiş oyunlarla ve insanlar üzerindne geliştirmişti. Bu hızlı ve garanti bir yöntem sunuyordu, ancak adına AlphaZero adını verdikleri yeni bir yapayzeka modelinde oyunun sadece kurallarını vererek kendi kendisiyle oynayarak öğrenmesini insanların oyunlarıyla eğitmeden denediler. Böylece bir yapay zekâya yalnızca oyunun kurallarını verip kendi kendine deneyim kazanmasını sağlarsak, insanlardan strateji öğrenmeden de güçlü oyun becerileri geliştirebilir mi? AlphaGo, insanın geliştirdiği stratejilerin ötesine geçebileceğini gösterdi. AlphaZero, satrançta yalnızca 4 saatlik kendi kendine öğrenmenin ardından AlphaGO’nun son sürümüyle yapılan karşılaşmayı yendi.
Oyuncu beynimiz kendi yarattığı yapay zeka ile oyunlar oynayarak önemli bir seviyeye gelebilir. işçi John Henry gibi ya da Kasparov gibi yapay zekanın kendisini geçemeyeceğini kabul etmeyerek değil, onu kabul ederek işe nasıl faydalı ve kontrollü bir şekilde mesela çocuklarımıza eğitim veren oyunlar yaptırmak ya da yaşça büyüklerimize sağlıklı egzersizleri oyunlaştırmak üzere düşünme zamanı.
Ercan Altuğ Yılmaz – Gamfed Türkiye

Yorum gönder